前言
书接上回,接着来说一下模型有关的部分和一些实验细节。
模型
与《Attention is all you need》这篇论文中的模型实现有些不同,主要是改变了位置编码的方式和norm的先后顺序。先来看一张文档里面的总体架构图:
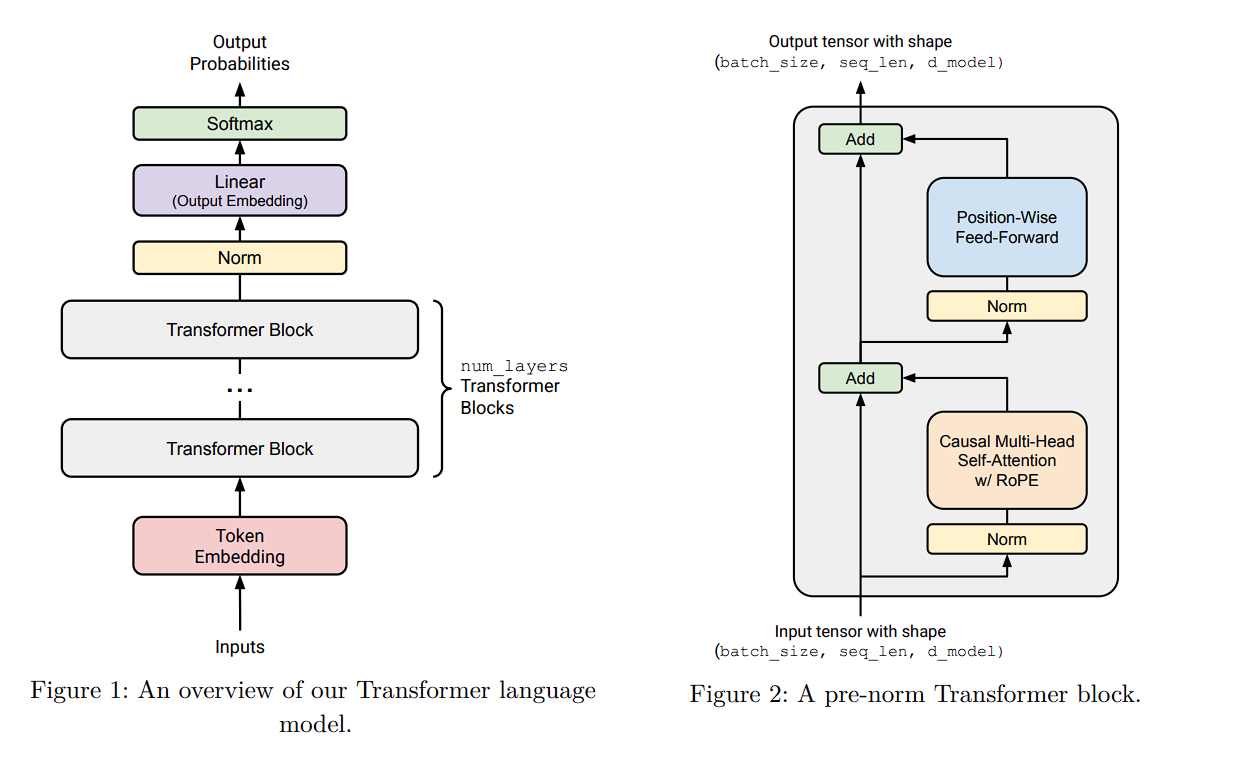
图1说明了怎么从一个输入中得到next token,当然,这是推理部分的内容了。来看看每个Transformer Block 的详细结构吧。
pre-norm:可以看到norm是在注意力机制计算之前的,原因是这样会保证residual过程的梯度完整流动- 多头注意力机制:这里不详细说明
- 前向网络
我们来看看模型的每一部分。
嵌入层
我们之前提到过,计算机只能接受离散的输入。假如有一句话input,其shape为(seq_len, ),更一般的,为了加快训练,一般会输入一个小批次,即input.shape为(batch, seq_len)。而为了让每个词具有“语义”的功能,我们一般会给每个词增加一个维度,即
|
|
也就是说,嵌入层要起到索引的作用,给定一个长度为(seq_len,)的输入,要返回这些id的对应向量。在得到对应向量后,下一层就是norm层。
RMSNorm
给定激活向量a,$a ∈ R ^ {d_{model}}$,RMSNorm将如以下重新缩放每个激活值$a_i$:
$$
RMSNorm(a_i) = \frac{a_i}{RMS(a)}g_i
$$
其中,$RMS(a) = \sqrt{\frac{1}{d_{model}}\sum_{i=1}^{d_{model}}a_i^2 + \varepsilon}$,这里$g_i$是一个可学习的参数,而$\varepsilon$通常是一个取值为1e-5的参数。
在很多地方,当缩放因子出现在分母上时,往往需要加上一个超参数$\varepsilon$,主要是防止除0错误
也就是说,我们之前把每个token用一个维度为d_model的维度进行表示,而i表示d_model的单个位置元素,也就是说每个位置的缩放程度不一致。下面是一个代码实现:
|
|
FNN前向网络
FNN应该都很熟悉了,我们首先来看看一般是怎么构建的。
数学表示与pytorch写法
在数学中,一组特征$X$通常可以用列向量表示:
$$
X =
\begin{bmatrix}
x_1 \
x_2 \
x_3 \
\vdots \
x_n
\end{bmatrix}
$$
对于列向量,我们对其做线性组合的时候,改变的是其行的个数,比如,给定一个变换$W$,其表示为:
$$
W =
\begin{bmatrix}
w_1 & w_2 & w_3 & \dots & w_n
\end{bmatrix}
$$
对$X$进行线性组合的结果可以表示为:
$$
Y = WX
$$
即$Y$:
$$
WX =
\begin{bmatrix}
w_1 & w_2 & w_3 & \dots & w_n
\end{bmatrix}
\begin{bmatrix}
x_1 \
x_2 \
x_3 \
\vdots \
x_n
\end{bmatrix}
$$
而在pytorch或者计算机编程习惯中,我们习惯把特征放在每一行,然后特定个数的行组成一个batch,所以,在表示上,我们操作的是行向量,此时,$ X = X^\top $,我们这里还是用行向量来表示$X$:
$$
X =
\begin{bmatrix}
x_1 & x_2 & x_3 & … x_n
\end{bmatrix}
$$
此时,对于矩阵来说,数学上列向量的写法和pytorch中行向量计算结果一直,即:
$$
Y = Y ^ \top
$$
则: $$ WX = (WX) ^ \top = X^\top W^\top $$ 所以我们需要右乘一个$W$的转置矩阵。
注意,对于一个向量来说,左乘一个矩阵是对向量进行行组合,右乘一个矩阵是对其进行列组合,这一点可以从矩阵乘法中进行理解,即对于两个矩阵进行乘法运算时,必须满足(M, N) 和(N, K)这种中间形状一直的规则
线性层的实现
因此,对于一个线性层,其运算结果是: $$ out = X \times Weight ^ \top $$ 我们来看看代码实现:
|
|
Pytorch的API实现的非常好,让我们可以无感的计算两个矩阵乘法,可以看到比较有意思的是,为了达到和表达式一致,在__init__函数中是先传入in_features再传递out_features,而存储weight的时候却是存储的shape = (out_features, in_features)。
残差和激活层
这两部分内容大家应该是相当熟悉的了,文档里面采用了一种全新的方式来计算激活方式,即使用不同的激活函数,即SwiGLU激活函数。这个激活函数,分为两部分,包括SiLu激活函数和门控制单元GLU。
SiLu(Swish)激活函数
这个激活函数比较简单,是一个sigmoid函数的输出和对于输入相乘,首先给出sigmoid函数:
$$
\sigma(x) = \frac{1}{1 + e^{-x}}
$$
这样就得到SiLu是:
$$
SiLu(x) = x \cdot \sigma(x) = \frac{x}{1 + e^{-x}}
$$
门控制单元
定义:经过
sigmoid函数的线性变换与另一个线性变换的逐元素乘积$GLU(x, W_1, W_2) = \sigma(W_1 x) \odot W_2x$
门控制单元好处是既给梯度提供线性路径,同时也保留了非线性能力,将SiLU和GLU结合在一起,得到SwiGLU,我们把它用于FNN中:
$$
FNN(x) = SwiGLU(x, W_1, W_2, W_3) = W_2(SiLU(W_1x) \odot W_3x)
$$
引入W2是为了让输出值重新回到d_model方便前后连贯的计算。
Rope相对位置嵌入
self-Attention就是去用每个Query和Key去做内积,得到每个token之间的注意力分数,就像下面这个矩阵中展示的一样 $$ \begin{bmatrix} & token_1 & token_2 & token_3 & token_4 \ token_1 & score_{(1, 1)} & score_{(1, 2)} & score_{(1, 3)} & score_{(1, 4)}\ token_2 & score_{(2,1)} & score_{(2,2)}& score_{(2, 3)} & score_{(2, 4)}\ token_3 &score_{(3,1)}& score_{(3,2)}&score_{(3,3)} & score_{(3,4)} \ token_4 & score_{(4,1)} & score_{(4,2)} & score_{(4,3)} & score_{(4,4)}\ \end{bmatrix} $$
对于注意力分数的计算来说,实际上Attention机制并具有顺序,简单来说,对于$X = [x_1, x_2, x_3]$来说,计算注意力分数的时候可以发现即使调换顺序,输出也会调换顺序。用语言来说,对于["我", "爱", "你"]和["你", "爱", "我"]这个语言明显不一样的句子来说,你会发现其注意力分数的计算仅仅只是交换了一下位置,没有关键的语义信息。
所以在Transformer的原始论文中,作者引入了Position Embedding,即位置编码。其思路就是给每个token的d_model维度上进行编码,一般有两种方式编码:
- 根据
token的位置进行编码 - 把位置关系当成一个可学习的参数
在数学形式上,也可以分为相加或者相乘形式的位置编码。
我们来看看rope想要解决之前sin和cos形式位置编码没能解决的问题。
正余弦编码存在的问题
首先,对于输入$X_m$和$X_n$,经过位置编码后变为: $$ \tilde{\boldsymbol{x}}_m &= \boldsymbol{x}_m + \boldsymbol{p}_m,\quad \tilde{\boldsymbol{x}}_n = \boldsymbol{x}_n + \boldsymbol{p}_n \ $$ 这个时候需要进行变换组合,也就是得到$Q$和$K$向量: $$ \boldsymbol{q}_m &= W_q \tilde{\boldsymbol{x}}_m,\quad \boldsymbol{k}_n = W_k \tilde{\boldsymbol{x}}_n \ $$ 此时这两个式子的乘积为: $$ \boldsymbol{q}_m^\top \boldsymbol{k}_n &= \big(W_q(\boldsymbol{x}_m+\boldsymbol{p}_m)\big)^\top \big(W_k(\boldsymbol{x}_n+\boldsymbol{p}_n)\big) \ $$ 我们来把这个式子拆开来看: $$ (\boldsymbol{x}_m+\boldsymbol{p}_m)^\top W_q^\top W_k (\boldsymbol{x}_n+\boldsymbol{p}_n) \ $$ 然后再把括号给拆开得到: $$ \boldsymbol{x}_m^\top W_q^\top W_k \boldsymbol{x}_n
- \boldsymbol{x}_m^\top W_q^\top W_k \boldsymbol{p}_n
- \boldsymbol{p}_m^\top W_q^\top W_k \boldsymbol{x}_n
- \boldsymbol{p}_m^\top W_q^\top W_k \boldsymbol{p}_n $$ 可以看到,只有$\boldsymbol{x}_m^\top W_q^\top W_k \boldsymbol{x}_n$是我们需要的内积分数计算,其它都是噪声项。期间,有一些工作尝试去消除掉$p_m$和$p_n$的影响。
rope的思路
rope的思路是,我们在计算$q^\top k$的时候可以去找到一个函数:
$$
<f_q(\boldsymbol{x_m}, m), f_k(\boldsymbol{x_k}, n)> = g(\boldsymbol{x_m}, \boldsymbol{x_n}, m-n)
$$
就是说将这两个内积转为一个与m-n有关的函数,当m和n向前或者向后移动t时,其attention score还可以保持不变。
推导过程
我们可以进行假设:位置编码可以表示为对x的一个线性变换,我们把这些线性变换写做:
$$
\boldsymbol{f}(x_m, m) = \boldsymbol{R}_m \boldsymbol{x}
$$
接下来我们考虑下面两个位置:
$$
\boldsymbol{f}(q, m) = \boldsymbol{R}_m \boldsymbol{q} \
\boldsymbol{f}(k, n) = \boldsymbol{R}_n \boldsymbol{k}
$$
其中,对于两个向量$<\boldsymbol{a}, \boldsymbol{b}>$的内积可以表示为$\boldsymbol{a}^\top \boldsymbol{b}$,所以,这两个位置做内积的形式就是:
$$
<\boldsymbol{f}(q, m),\boldsymbol{f}(k, n)> = ( \boldsymbol{R}_m \boldsymbol{q})^ \top \boldsymbol{R}_n \boldsymbol{k}
$$
把转置部分拆开:
$$
( \boldsymbol{R}_m \boldsymbol{q})^ \top \boldsymbol{R}_n \boldsymbol{k} = \boldsymbol{q}^ \top \boldsymbol{R}_m^\top \boldsymbol{R}_n \boldsymbol{k}
$$
也就是说,为了让这个式子去只依赖m和n,我们能不能找到一个解,使得:
$$
\boldsymbol{R}_m^\top \boldsymbol{R}n = \boldsymbol{R{n-m}}
$$
这样一来,有没有办法找到一个矩阵,使得其计算满足上面的结果呢?答案就是旋转矩阵。
旋转矩阵
一个比较简单的视角去推导旋转矩阵就是使用极坐标的方式去进行推导
我们先从二维的旋转矩阵开始,对于一个二维向量: $$ \boldsymbol{X} = \begin{bmatrix} x_1 \ x_2 \ \end{bmatrix} $$ 如果要对其进行逆时针旋转,那么就可以使用旋转矩阵$R$ $$ \boldsymbol{R}(\theta) = \begin{bmatrix} cos(\theta) & -sin(\theta) \ sin(\theta) & cos(\theta) \end{bmatrix} $$ 其中,$\theta$表示逆时针旋转后的角度,那么旋转后的向量就是$R(\theta)X$, $$ x_1’ = x_1 \times cos(\theta) - x_2 \times sin(\theta) \ x_2’ = x_1 \times sin(\theta) + x_2 \times cos(\theta) $$
性质1:矩阵的转置等于逆向旋转
逆向旋转就是让$\theta = -\theta$,我们把这一项带入旋转矩阵中: $$ \boldsymbol{R}(-\theta) = \begin{bmatrix} cos(-\theta) & -sin(-\theta) \ sin(-\theta) & cos(-\theta) \end{bmatrix} $$ 根据三角函数的性质,$cos(-\theta) = cos(\theta), sin(-\theta) = -sin(\theta)$,把这一项带入,得到旋转矩阵: $$ \boldsymbol{R’}(\theta) = \begin{bmatrix} cos(\theta) & sin(\theta) \ -sin(\theta) & cos(\theta) \end{bmatrix} $$ 注意到这两个正好满足$\boldsymbol{R’}(\theta) = \boldsymbol{R}(\theta) ^ \top $,即与$\theta$相反方向的旋转矩阵正好是原来旋转矩阵的转置,从正交矩阵的角度来理解,负方向的旋转正好是原来矩阵的逆矩阵。
性质2:连续旋转等于角度相加
一个很直观的想法是,先朝着一个方向旋转30°,然后再旋转40°,那么和像这个方向旋转70°是等价的。一般的,假设你先旋转$\alpha$度: $$ x’ = R(\alpha)x $$ 然后再旋转$\beta$度: $$ x’’ = R(\beta)x' $$ 代入得: $$ x’’ = R(\beta)R(\alpha)x $$ 因此: $$ R(\beta)R(\alpha) = R(\beta + \alpha) $$
位置映射
现在我们已经推导出了旋转矩阵,只要想办法把位置m,n映射到旋转角度上就行。一个想法是让旋转角度和位置成正比,即:
$$
\theta_m = m\theta
$$
其中,$\theta$可以理解为一个固定得数值。所以,任意位置$m$的旋转矩阵为:
$$
R_m =
\begin{bmatrix}
cos(m\theta)& -sin(m\theta) \
sin(m\theta)& cos(m\theta)
\end{bmatrix}
$$
验证结果
假设$q, k$为:
$$
q =
\begin{bmatrix}
q_1 \
q_2
\end{bmatrix} \
k =
\begin{bmatrix}
k_1 \
k_2
\end{bmatrix}
$$
两个token在seq中的位置为m和n,我们对这两个位置的token使用旋转矩阵进行位置编码:
$$
q_m = R(m\theta)q, k_n = R(n\theta)k
$$
计算注意力分数:
$$
\text{score}(m,n) = q_m^Tk_n
$$
计算过程如下:
- 带入旋转矩阵
$$ =(R(m\theta)q)^T (R(n\theta)k) $$
- 拆开矩阵转置
$$ =q^TR(m\theta)^TR(n\theta)k $$
- 利用旋转矩阵性质1:
$$ R(m\theta)^T = R(-m\theta) $$
- 所以此时等式等于
$$ =q^TR(-m\theta)R(n\theta)k $$
- 利用旋转矩阵性质2:
$$ R(-m\theta)R(n\theta)=R((n-m)\theta) $$
代入原式: $$ \text{score}(m,n) = q^\top R((n-m)\theta)k $$ 这样就求出了相对位置,并且消除了噪声项。
代码实现
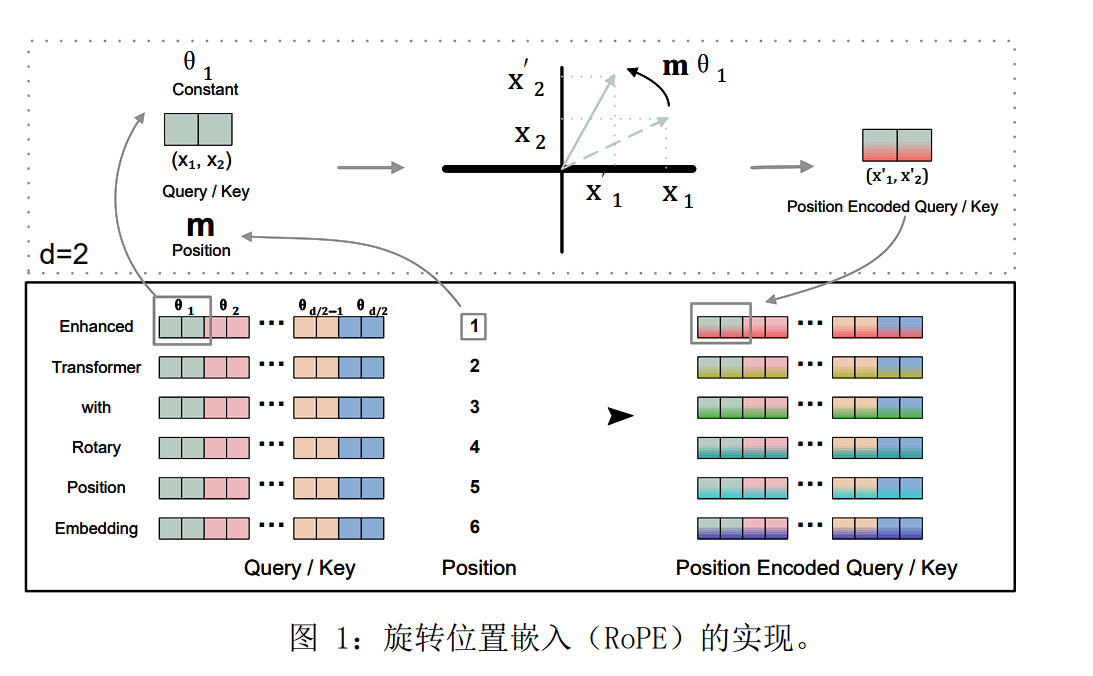
rope论文中提出了可以使用一组pair来计算高维向量的情况,即两两一对配对组合
|
|
总结
这次我们就记录到这里,下次接着来写!