title = ‘attention内容回顾记录’ date = 2026-09-18T18:30:53+08:00 draft = true
categories = [“eecs498”]
tags = [“llm”]
+++
前言
在之前的课程中我们学习了RNN和LSTM两种网络,当处理的目标是连续的内容时,比如说翻译,这种网络可以很好的解决连续序列的问题,但之后的故事大家都知道了,transformer横空出世,我们来看看RNN有哪些未解决的问题吧。
RNN的前生今世
encoder-decoder架构
在执行翻译任务时,有着encoder和decoder的编码器结构应该是这样的:
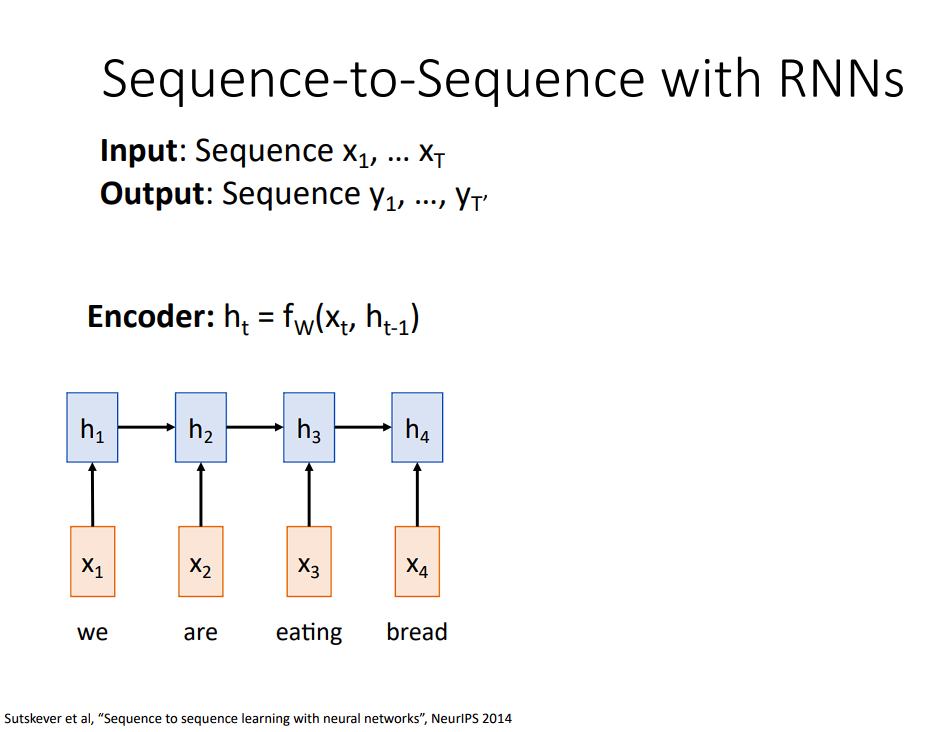
即,当前t时刻的隐藏层与t-1时刻的隐藏层和当前输入x有关,在encoder经过编码后会得到一个最终向量,我们一般叫做context上下文向量,其翻译过程就是这样
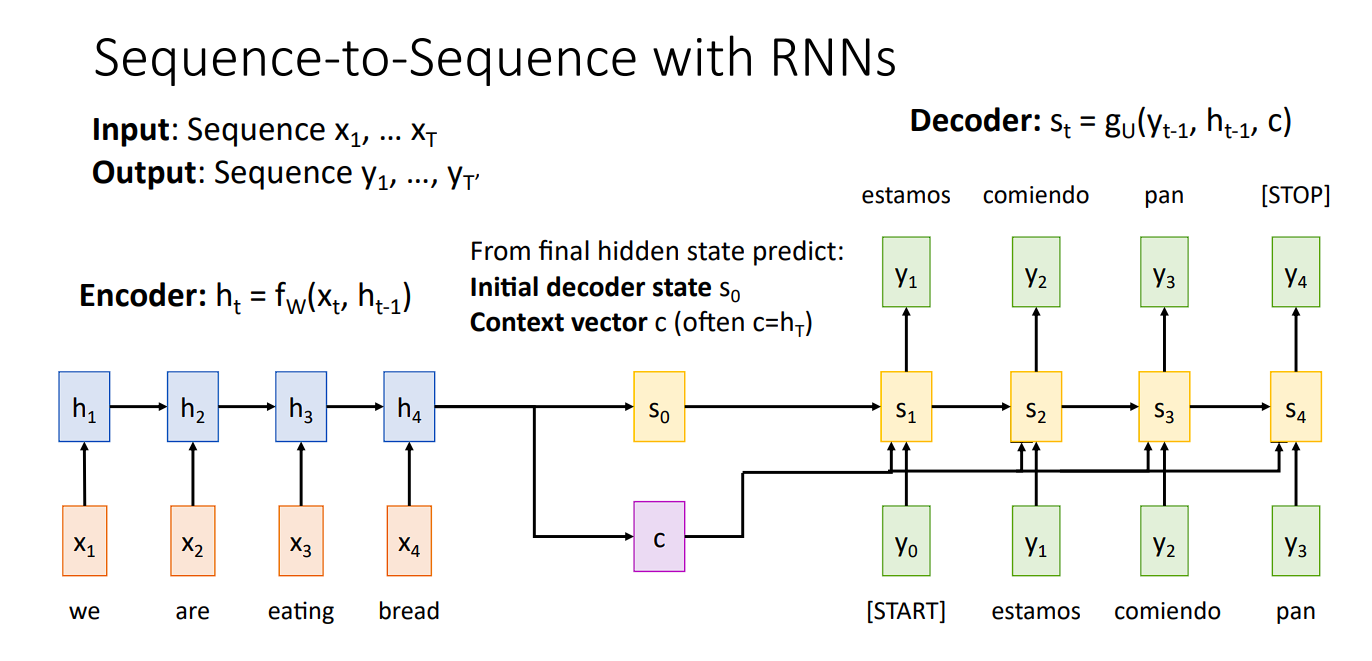
可以看到,在decoder的每一步中都用到了这个上下文向量,我们可以理解为:
encoder所有的信息都压缩在这个向量中deocder根据这个上下文向量和rnn网络进行预测生成
缺点
当序列变得很长时,例如有1000步,这也就意味着我们需要把1000步的内容给进行压缩,这会丢失掉许多信息。
attention改进
一个很棒的思路是,我们在decoder的过程中,为什么总是使用一个压缩的上下文向量呢,而不是每次都去计算一个新的上下文向量呢?如下图所示:
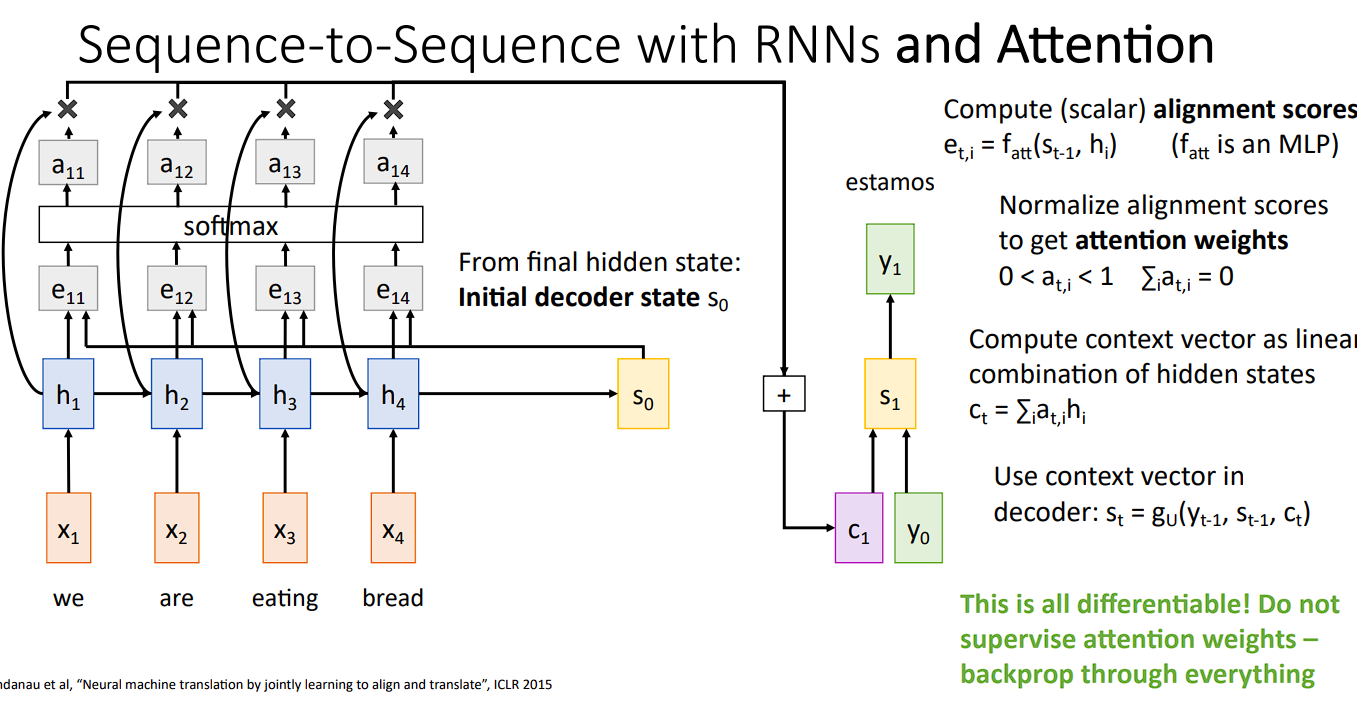
我们在这里看到的注意力机制叫做Bahdanau attention,也叫加法注意力机制。
decoder的过程和之前的不变,需要注意的是,每一次都需要去计算一个新的上下文向量,我们来说明一下这个计算过程:
-
在
decoder阶段,我们使用encoder阶段最后的隐藏层$h_t$作为decoder的初始值$s_0$,当我们计算第一个上下文向量$c_1$的时候需要使用这个$s_0$向量,其计算流程如下 $$ e_{t,i} = f_{att}(s_{t-1}, h_i) $$ -
在得到注意力分数的这个过程其实就是对前
T时刻所有的隐藏层进行权重分配的过程。可以这样理解,一个隐藏层包含单词及周围词性信息,在decoder的过程中,每个词的关注度不可能都是一样的,我们需要聚焦与某个单词。所以,$s_0$实际上也是包含了单词的所有信息,这样,在每一个时间步T上,我们就可以做到物尽其用。
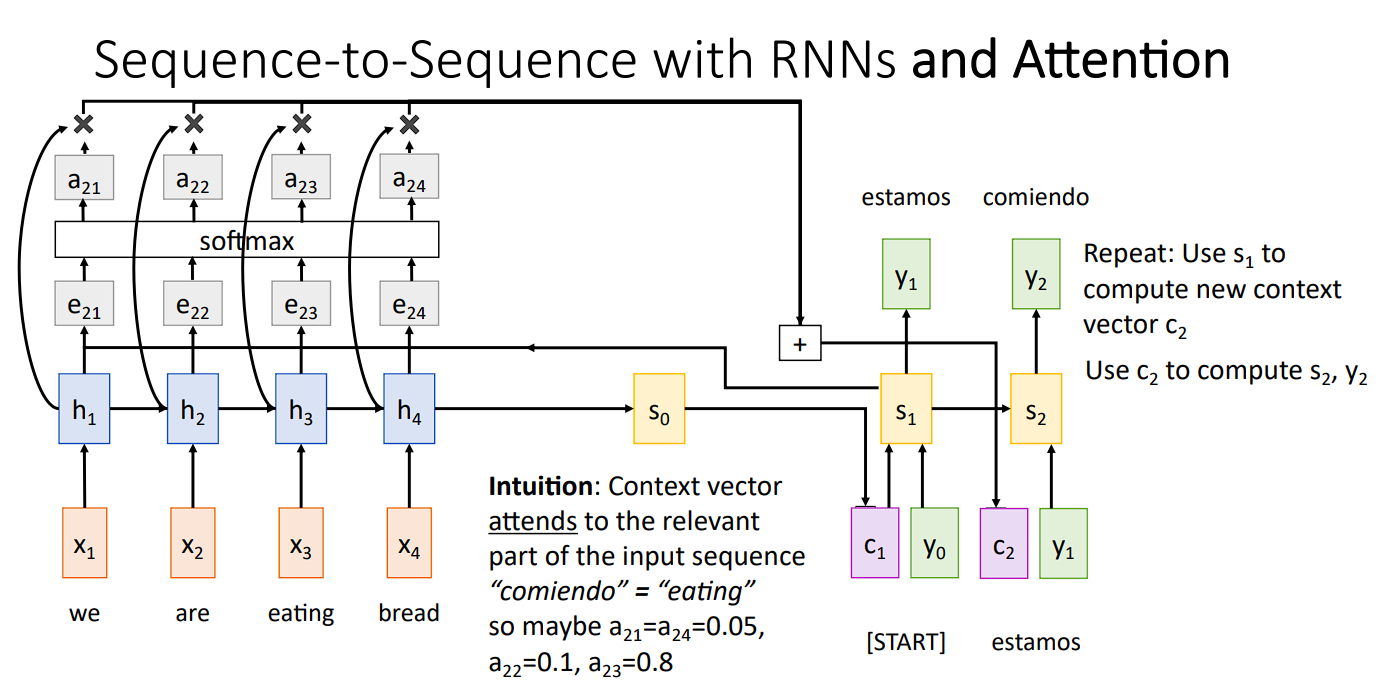
计算过程如上图所示
Attention
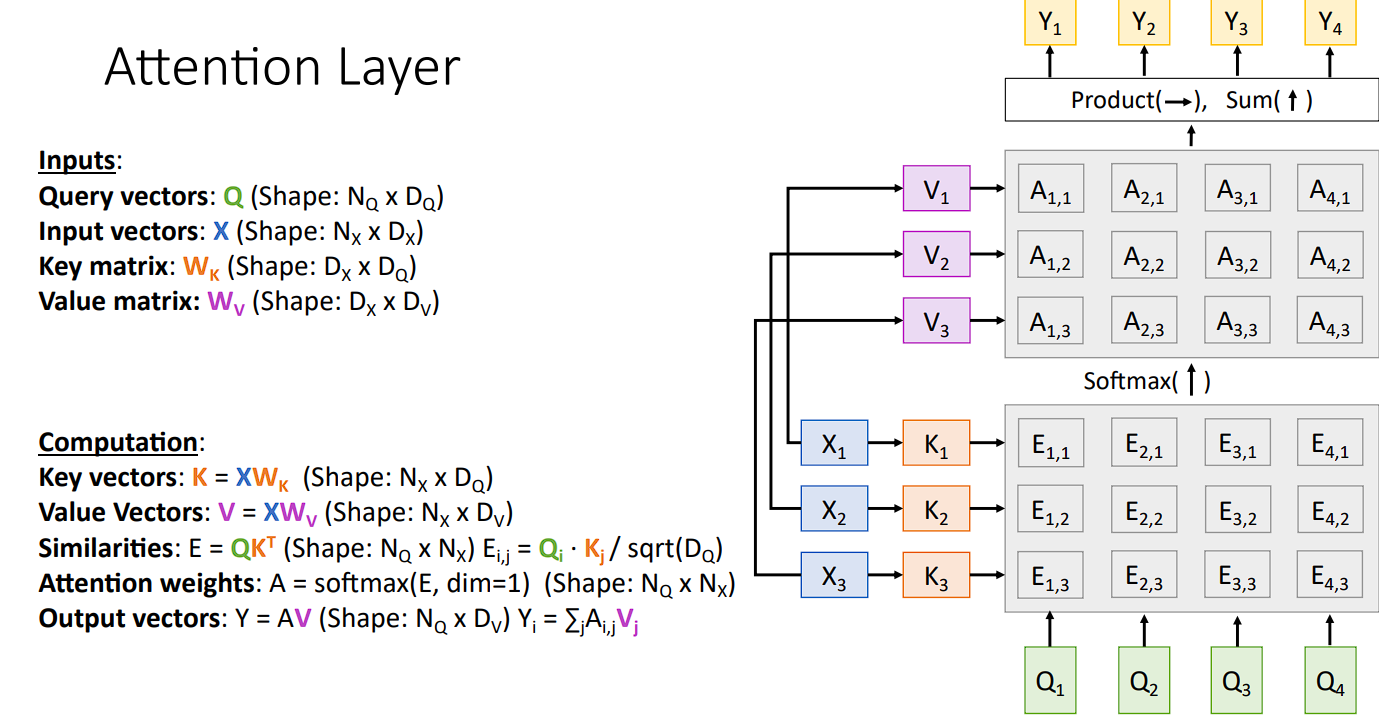
更一般的,我们把这种查询抽象为一个注意力层
交叉注意力
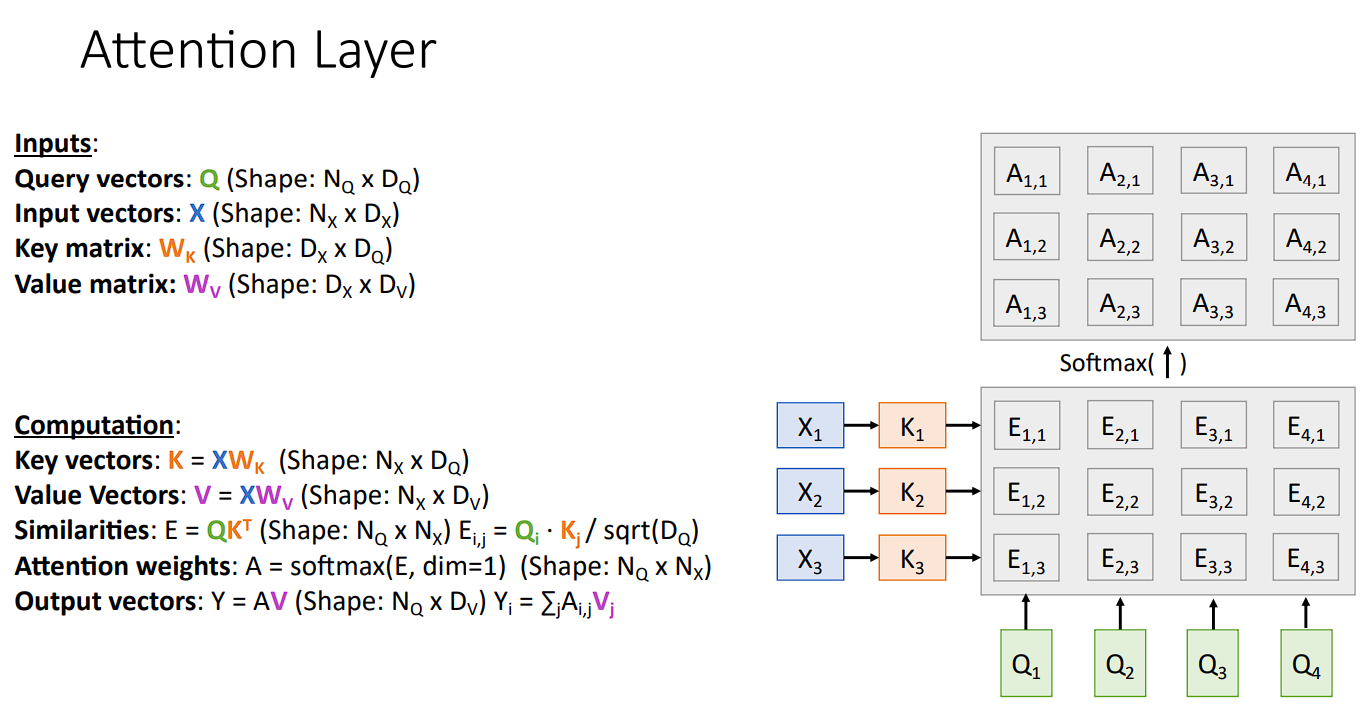
如之前RNN中介绍的,我们需要把当前输入去之前的encoder中进行匹配计算,好比人类做翻译的时候需要去看译文。
自注意力机制
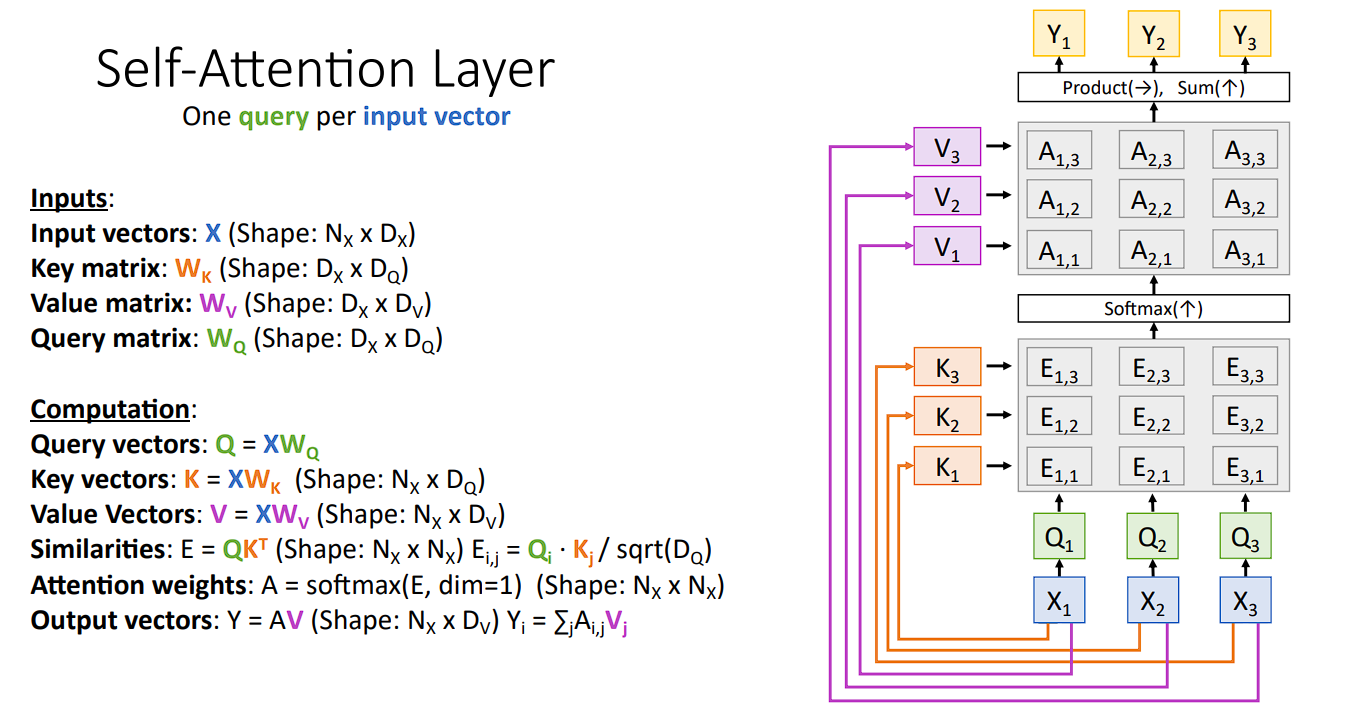
与之不同的是,自注意力机制的Q,K,V全部来自输入X
多头注意力机制
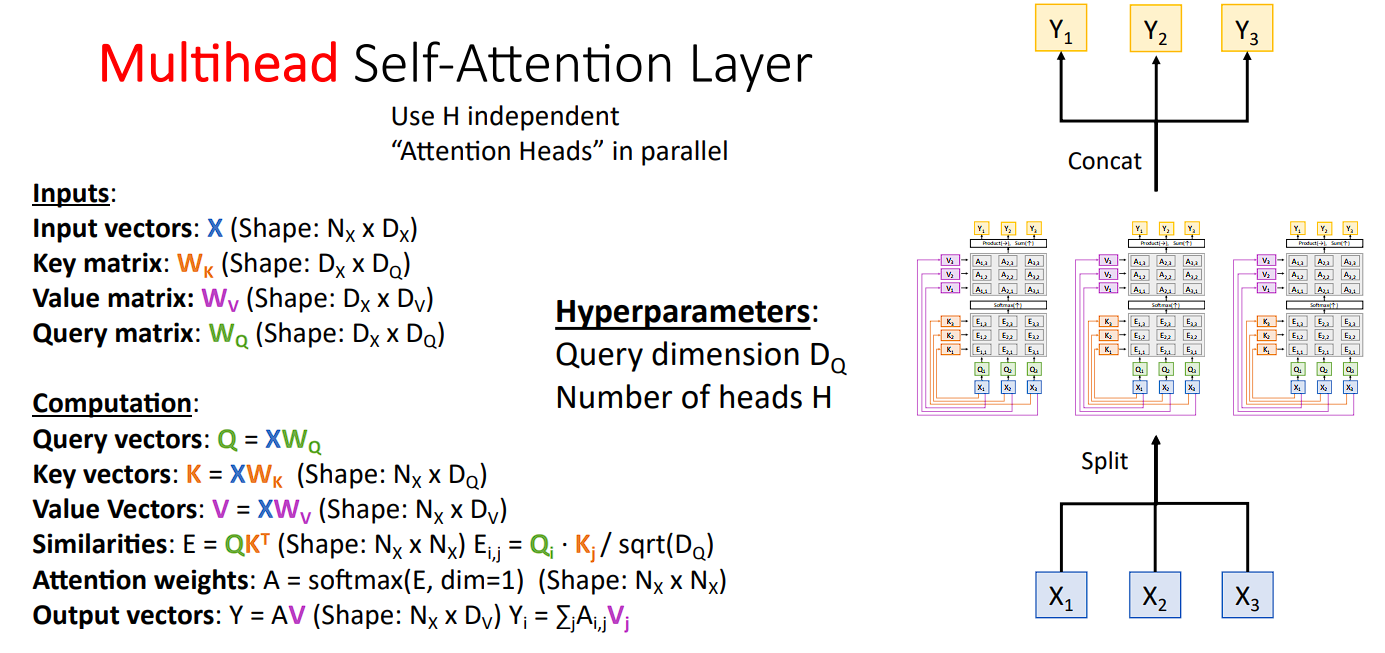
前后输入输出向量维度不变,将输入向量X进行维度分配,随后把得到的向量拼接起来